
Data Mirroring: Business Central und Microsoft Fabric wachsen zusammen
Teilen:
Die Fachabteilung braucht eine neue Auswertung. Die Daten liegen in Business Central vor und trotzdem dauert es Wochen, bis der Bericht steht. Dabei wäre die Analyse an sich recht schnell erstellt. Was Zeit kostet, ist der Weg der Daten aus dem ERP.
Für viele Anforderungen sind die Standard-APIs von Microsoft ausreichend. Alles, was darüber hinausgeht fehlt – beispielsweise ein bestimmtes Feld oder eine Tabelle – war mit Zusatzaufwand verbunden. Und das kostet Zeit, bevor die eigentliche Analyse starten kann.
Ende September 2026 hat Microsoft auf der FabCon Europe in Barcelona einen neuen Weg für diese Aufgabe vorgestellt: Data Mirroring für Business Central in Microsoft Fabric. In diesem Beitrag erfahren Sie, wie die Integration funktioniert, was sie voraussetzt und welchen Unternehmen sie den Weg zu ihren Daten deutlich verkürzt.
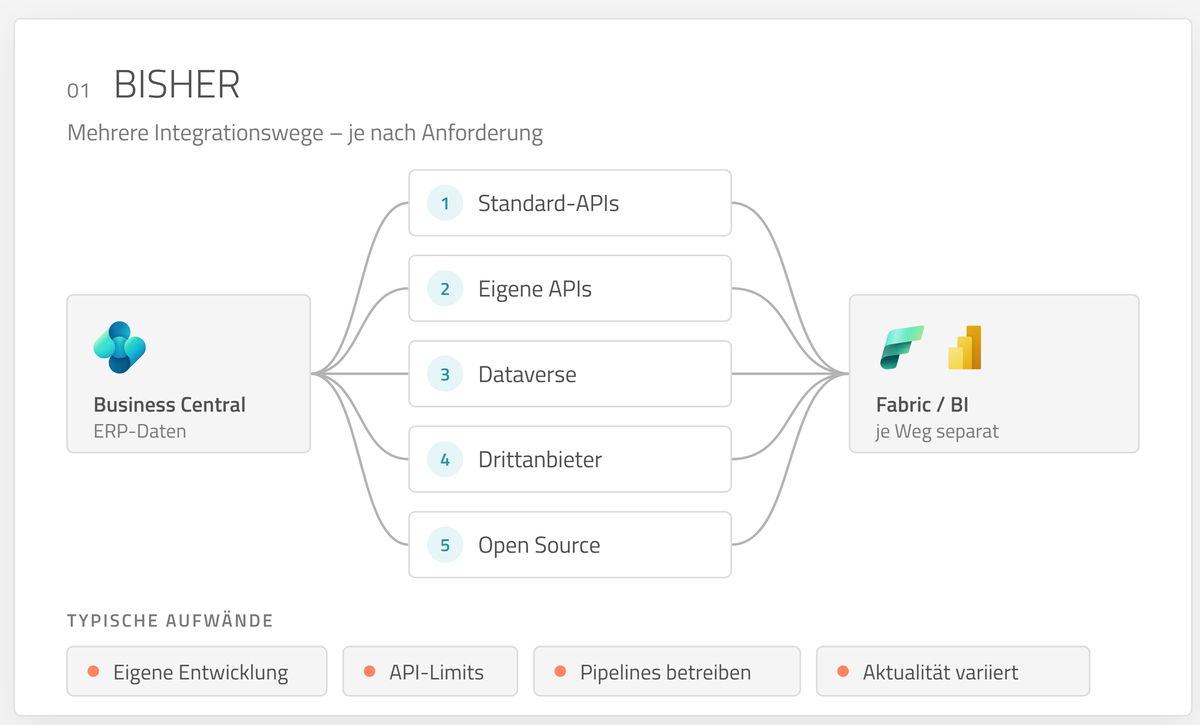
Die bisherige Realität: Viele Wege führen zu den Business Central-Daten
Schon heute lassen sich Daten aus Business Central auf verschiedenen Wegen für Auswertungen bereitstellen. Welcher Ansatz in einem Projekt zum Zug kommt, hängt von den Anforderungen ab:
- Standard-APIs von Microsoft
- Dataverse
- individuell entwickelte APIs
- Lösungen von Drittanbietern
- Open-Source-Projekte wie BC2ADLS
Diese Wege haben sich in vielen Projekten bewährt. Sobald eine Anforderung über die Standardfunktionen hinausgeht, wächst allerdings der Aufwand.

„Aus unseren Projekten kennen wir das gut. Alle Daten, die die Standard-API von Microsoft nicht liefert, muss ein Business Central-Entwickler über eine eigene API zugänglich machen. Der einzelne Aufwand ist überschaubar, über mehrere Anforderungen hinweg summiert er sich aber.“
Arne Trümper | Consultant BI
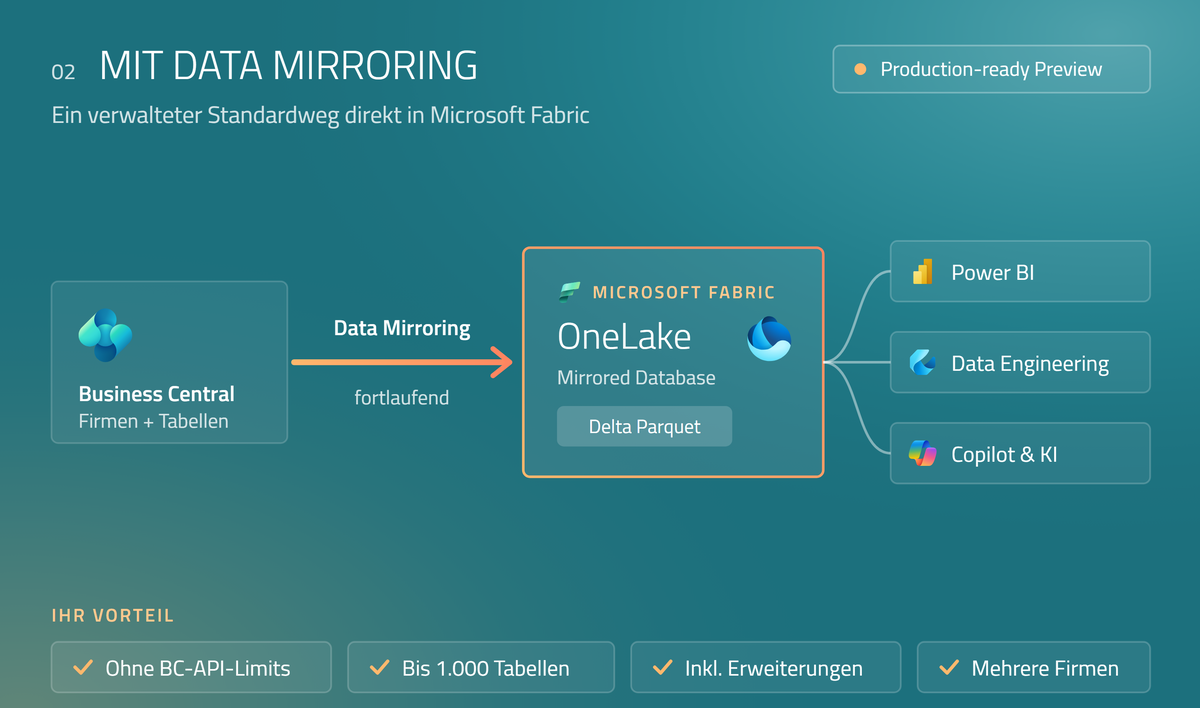
Noch schwerer wiegt die Zeit: Jede neue API muss erst entwickelt und ins Produktivsystem übernommen werden. So lange wartet das Analyseteam, und die Auswertung beginnt später als geplant. Mit Data Mirroring stellt Microsoft erstmals einen eigenen Standardweg bereit, um Business Central-Daten direkt nach Fabric zu übertragen. In vielen Szenarien entfällt damit der Umweg über eigene APIs oder zusätzliche Hilfslösungen.
Business Central-Daten direkt in Microsoft Fabric nutzen
Mit Data Mirroring repliziert Business Central seine Daten fortlaufend in eine Mirroring-Datenbank in Microsoft Fabric. Dort liegen sie in OneLake und stehen für Reporting, Analytics, Power BI und KI-Anwendungen bereit. Übertragen werden dabei immer alle Felder einer Tabelle. In Fabric entsteht so ein vollständiges, laufend aktualisiertes Abbild der ausgewählten Daten.
Die Einrichtung übernimmt ein Administrator in fünf Schritten:
- In einem Fabric-Arbeitsbereich eine Mirroring-Datenbank anlegen.
- Business Central mit dem Arbeitsbereich und der Datenbank verbinden.
- Dem Dienstprinzipal Zugriff auf die Mirroring-Datenbank gewähren.
- Die Mandanten und Tabellen auswählen, die übertragen werden sollen.
- Die Synchronisierung starten und überwachen.
Für den Einstieg stellt Microsoft ein Konfigurationspaket mit einer Auswahl an Standardtabellen bereit. Den Verlauf der Synchronisierung können Sie in Business Central, über APIs und in Fabric verfolgen. Gespiegelt wird pro Umgebung. Unterstützt werden alle AL-Tabellen, die in der SQL-Datenbank gespeichert sind. Damit sind Standardtabellen ebenso abgedeckt wie Tabellen aus Erweiterungen. Wer mehrere Gesellschaften in Business Central führt, kann deren Daten in Fabric zusammenführen.
Für die Replikation nutzt Microsoft einen internen Dienst und verzichtet auf die Business Central-APIs. Die API-Limits bleiben dadurch unberührt. Neue und geänderte Daten kommen nach wenigen Minuten in Fabric an, je nachdem, wie viel sich in Business Central gerade bewegt. Die erste historische Synchronisierung dauert länger als die anschließenden inkrementellen Abgleiche. Auch Löschungen werden nach Fabric übertragen.
Die wichtigsten Fakten im Überblick
Status: Microsoft plant die Funktion für Oktober 2026 als produktionsreife Vorschau (Production-ready Preview).
Voraussetzung: Business Central online ab 2026 Release Wave 2 (Version 29) und eine Microsoft-Fabric-Kapazität
Technik: Replikation über einen Microsoft-Dienst ohne Business Central-APIs, deren Limits bleiben unberührt
Datenformat: Delta Parquet in OneLake
Umfang: bis zu 1.000 ausgewählte Tabellen aus mehreren Mandanten, Standard- und Erweiterungstabellen; ein Konfigurationspaket von Microsoft enthält eine Auswahl an Standardtabellen
Aktualität: meist innerhalb weniger Minuten, die erste Synchronisierung dauert länger
Löschungen: werden mit übertragen
Kosten: auf Seiten von Business Central keine zusätzlichen Kosten. Benötigt wird eine aktive Fabric-Kapazität. Die Replikation selbst verbraucht keine Kapazität, und der Speicher für gespiegelte Daten ist bis 1 TB pro Capacity Unit kostenlos.
Stand: Oktober 2026. Microsoft führt die Dokumentation derzeit als Vorabversion und kann Voraussetzungen und Funktionsumfang bis zur allgemeinen Verfügbarkeit noch anpassen. Aktuelle Informationen finden Sie in der Microsoft-Dokumentation zu Data Mirroring für Business Central.
Der Mehrwert für Unternehmen
Analyseprojekte schneller starten
Sobald Data Mirroring eingerichtet ist, arbeiten Fachbereiche und Analyseteams direkt mit den Tabellen in Fabric. Taucht im Projekt eine neue Frage auf, wählen sie die passende Tabelle zusätzlich aus und können nach der ersten Synchronisierung loslegen. So wächst eine Analyse Schritt für Schritt, genau nach den Anforderungen der jeweiligen Fachabteilung.
Data Mirroring beschleunigt dabei vor allem die Bereitstellung der Daten. Damit aus den übertragenen Tabellen aussagekräftige Auswertungen werden, braucht es weiterhin passende Datenmodelle, die die Daten fachlich aufbereiten und sinnvoll verknüpfen.
Weniger Eigenentwicklung, mehr Standard
Da sich auch Tabellen aus Erweiterungen übertragen lassen, brauchen Sie für Analysen deutlich seltener eigene Schnittstellen. Data Mirroring ist Teil der Microsoft-Plattform und wird von Microsoft unterstützt. Zusatztools wie BC2ADLS lassen sich damit in vielen Szenarien ablösen, und Ihre Entwicklungskapazität bleibt frei für fachliche Anpassungen. Auch die Kosten bleiben überschaubar: Für Business Central selbst fallen keine zusätzlichen Kosten an, und die Replikation verbraucht keine Fabric-Kapazität. Die vorhandene Kapazität steht damit vollständig für Analysen bereit, sodass oft schon eine kleine Fabric-Kapazität für den Einstieg reicht.
Grundlage für Near-Real-Time-Analysen und KI
Sobald die Daten in Fabric liegen, nutzen Sie dieselbe Datenbasis in OneLake für BI, Analytics und KI. Typische Einsatzfelder sind:
- Berichte und Dashboards in Power BI
- Analysen und Datenmodelle in Microsoft Fabric
- Copilot- und KI-Agenten-Szenarien, die auf aktuelle ERP-Daten zugreifen
Weil Änderungen nach wenigen Minuten in Fabric ankommen, werden auch Auswertungen möglich, die bisher viel Aufwand oder hohe Kosten bedeuteten. Dazu zählen Near-Real-Time-Analysen ebenso wie unternehmensweite Auswertungen über mehrere Gesellschaften hinweg.
Microsoft baut diesen Weg weiter aus: Geplant sind Varianten der Standard-Power-BI-Apps für Business Central, die direkt auf die Daten in Fabric zugreifen, sowohl für einzelne Mandanten als auch mandantenübergreifend. Bis zur allgemeinen Verfügbarkeit kann sich das Angebot noch ändern.

Was ändert sich durch Data Mirroring? Der direkte Vergleich zeigt, wo sich für die Anwender Aufwand verschiebt:
| Anforderung | Bisherige Integrationswege | Mit Data Mirroring |
|---|---|---|
| Zusätzliche Tabellen bereitstellen | Oft entwickelt ein BC-Entwickler eine eigene API | Tabelle in der Konfiguration auswählen, bis zu 1.000 Tabellen |
| Daten aus Erweiterungen nutzen | Fehlende Daten über eigene APIs bereitstellen | Standard- und Erweiterungstabellen werden direkt unterstützt |
| Daten aktuell halten | Aktualität hängt von Integrationsweg, Budget und Know-how ab | Einfache, effiziente und fortlaufende Replikation, meist innerhalb weniger Minuten |
| Mehrere Gesellschaften auswerten | Daten aus den einzelnen Mandanten manuell laden und zusammenführen | Mehrere Mandanten zentral in Fabric |
| API-Limits | API-basierte Lösungen nutzen die verfügbaren Limits | Replikation läuft ohne APIs, Limits bleiben unberührt |
| Betrieb und Pflege | Ladeprozesse (Ingestion) selbst betreuen und überwachen | Microsoft übernimmt die Replikation, Datenmodelle, Transformationen und Auswertungen pflegen Sie weiterhin selbst |
| Kosten | Abhängig vom Integrationsweg, bei hoher Aktualität oft spürbar | Replikation verbraucht keine Fabric-Kapazität, Speicher bis 1 TB pro Capacity Unit inklusive |
Für welche Unternehmen ist das besonders interessant?
Data Mirroring entfaltet seinen Nutzen vor allem dort, wo Daten aus Business Central heute mit Aufwand bereitgestellt werden oder künftig eine größere Rolle spielen sollen. Das betrifft insbesondere Unternehmen, die
- komplexes Reporting betreiben und dafür heute viele eigene APIs oder Exporte pflegen,
- mehrere Gesellschaften in Business Central führen und gemeinsam auswerten möchten,
- BI-Projekte planen oder ihre Power-BI-Berichte auf eine einheitliche und breitere Datenbasis stellen wollen,
- Microsoft Fabric einführen oder bereits nutzen und Business Central als Quelle anbinden möchten,
- KI-Initiativen vorantreiben und dafür aktuelle ERP-Daten brauchen.
Fazit: Business Central wird Teil der Daten- und KI-Plattform
Die Ankündigung zeigt, wohin sich die Microsoft-Plattform entwickelt. Business Central rückt näher an Microsoft Fabric heran und wird Teil einer durchgängigen Daten- und KI-Landschaft. Unternehmen, die ihre ERP-Daten stärker für Analysen, Automatisierung und KI nutzen möchten, bekommen mit Data Mirroring einen deutlich einfacheren Weg, als ihn viele der heute eingesetzten Individuallösungen bieten.
Noch steht die Funktion am Anfang. Microsoft hat die Dokumentation bereits veröffentlicht, die produktionsreife Vorschau ist für Oktober geplant. Ein guter Zeitpunkt also, um die eigene Datenstrategie zu prüfen: Welche Daten fließen heute über eigene APIs oder Zusatztools nach draußen? Und welche Auswertungen werden erst mit aktuellen Daten möglich?
Gern klären wir diese Fragen gemeinsam mit Ihnen. Sprechen Sie uns über unser Kontaktformular an.
FAQ
Data Mirroring repliziert Tabellen aus Business Central fortlaufend in eine Mirroring-Datenbank in Microsoft Fabric. Dort stehen die Daten als laufend aktualisiertes Abbild für Power BI, Analytics und KI-Anwendungen bereit.
Data Mirroring steht für Business Central online ab 2026 Release Wave 2 (Version 29) zur Verfügung. Auf der Fabric-Seite benötigen Sie eine Fabric-Kapazität, also eine F-SKU (in der Regel ab F2) oder eine bestehende P-SKU, sowie einen Arbeitsbereich für die Mirroring-Datenbank.
Nein. Die Replikation läuft über einen internen Microsoft-Dienst und kommt ohne die Business Central-APIs aus.
Die Replikation selbst verbraucht keine Fabric-Kapazität. Auch der Speicher für die gespiegelten Daten ist bis 1 TB pro Capacity Unit kostenlos. Kapazität benötigen Sie erst für die Analysen, die Sie anschließend auf den Daten ausführen.
Änderungen kommen nach wenigen Minuten in Fabric an. Die genaue Dauer hängt davon ab, wie viele Daten sich in Business Central ändern. Die erste Synchronisierung dauert länger.
Ja. Unterstützt werden alle AL-Tabellen, die in der SQL-Datenbank gespeichert sind, also Standard- und Erweiterungstabellen.
Für Business Central fallen keine zusätzlichen Kosten an. Auch auf der Fabric-Seite verbraucht die Replikation keine Ressourcen. Sie benötigen lediglich eine aktive Fabric-Kapazität, über die Ihre Analysen laufen.


